AI用語の基礎知識
【第29回】「モデル蒸留」とは――巨大AIの“賢さのエッセンス”を小さなAIに引き継ぐ技術
2026年11月2日 10:02

最近のAIニュースでは、「小型モデルなのに、ひと昔前の巨大モデルに匹敵する性能」といった話題を見かけます。
【第24回】の「パラメーター」で紹介したように、大規模なAIは高い性能を発揮しやすい反面、動かすためのメモリや計算コストもかさみます。巨大モデルの中には、とても手元のPCでは動かせないものもあります。
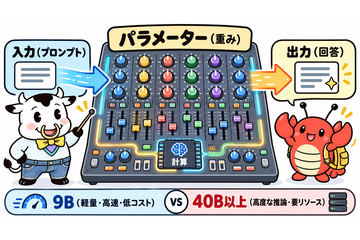
そこで注目されるのが、大きなAIを「先生」にして、小さなAIを鍛える「モデル蒸留(知識蒸留)」です。
「先生AI」から「生徒AI」へ、賢さを伝授
「蒸留」とは本来、液体を加熱して気化した成分を冷やし、取り出す技術。ウイスキーづくりでもおなじみですね。AIの世界では、巨大モデルが持つ能力の要点を、小さなモデルに学ばせることを指します。
お手本になるのが「教師モデル」、学ぶ側が「生徒モデル」です。
資格試験に例えてみましょう。大量の教科書を片っ端から読んで独学する代わりに、ベテラン講師について勉強するようなものです。先生が出した模範解答や解説を教材にして、効率よく力をつけていくわけですね。
ただし、先生AIの中身をそのまま小さなAIへコピーするわけではありません。先生が質問にどう答えるか、選択肢をどう評価するか、といった出力を手がかりに、生徒AI自身のパラメーターを学習で調整します。
「正解はA」だけでなく、「Bも惜しいが、ここが違う」といった判断の傾向まで参考にできることがあります。また最近では、先生AIが生成した解法の手順を教材にする蒸留も行なわれています。
例えば、問い合わせ対応のAIを作るなら、さまざまな質問を教師モデルに投げ、適切な回答例を作ってもらいます。生徒モデルはその回答を参考に学習するので、一からすべてを試行錯誤するより効率よく、特定の仕事を覚えられる可能性があるのです。
しかも、蒸留が終われば、通常は大きな先生AIを毎回呼び出す必要はありません。小さな生徒AIが単独で回答するので、使う場面での負担が小さくなるわけです。
小さくても賢いAIがもたらす3つの利点
第一は、運用コストの削減です。巨大モデルに毎回仕事を頼む代わりに、同じ用途で十分な性能を持つ小型モデルを使えば、必要な計算資源や費用を抑え、応答を速くできる可能性があります。
第二は、手元で動くAIの高性能化です。【第14回】の「SLM(小型言語モデル)」や【第26回】の「ローカル推論」とも関係します。蒸留は、スマートフォンやPCで使いやすい小型AIを育てる方法の一つなのです。

第三は、特定の能力の継承です。例えば【第5回】で取り上げた「推論モデル」が生成する解法や説明を学ばせ、数学やプログラミングなどの課題で小さなモデルの性能を高める試みが進んでいます。すべての知識を丸ごと引き継ぐのではなく、得意分野を絞って鍛えることもできるわけです。


「先生」が間違えば、「生徒」も間違う
もちろん、万能ではありません。生徒モデルは教師モデルと同じ性能になるとは限りませんし、先生の偏見や間違い、ハルシネーションまで学んでしまう可能性があります。
また、他社の商用AIの回答を大量に集めて学習に利用する場合は、サービスの利用規約や許諾条件に注意が必要です。公開されているモデルでも、出力の再利用や蒸留が認められるかは個別に確認しなければなりません。
さらに、蒸留は【第12回】の「ファインチューニング」を使って実現する場合もあります。一方、数値の表現を減らしてモデルを軽くする「量子化」とは、仕組みが異なります。

「AIは大きければ大きいほどいい」とは限らない時代。巨大AIの知恵を、必要な形で小さなAIに学ばせる。モデル蒸留は、高性能なAIを私たちの身近な端末や仕事へ広げるための、重要な技術なのです。