AI用語の基礎知識
【第28回】「AIレッドチーミング」とは――あえて“攻撃者役”になりきってAIの弱点を探る実戦テスト
2026年10月26日 11:58

企業が独自のAIチャットボットを開発したり、新しい生成AIモデルを公開したりする際、「安全性を十分に検証しました」と発表することがあります。
しかし、AIは自然な言葉でやり取りできるからこそ、開発者が想定しなかった巧妙な言い回しで誘導され、禁止しているはずの危険な回答をしてしまう場合があります。
そうした想定外の弱点や抜け道を、「攻撃者の目線」であえて探し出す手法が、今回取り上げる「AIレッドチーミング」です。
味方があえて「敵役」を演じる
「レッドチーミング」は、もともと軍事演習やサイバーセキュリティの世界で使われてきた言葉です。守る側を「ブルーチーム(青組)」、攻める側を「レッドチーム(赤組)」として、実戦に近い演習を行ないます。
AIレッドチーミングでは、開発者や専門家があえて「悪意ある攻撃者」や「無茶な使い方をするユーザー」になりきり、AIの安全対策を突破できないか試します。人間による試行に加え、大量の質問を自動的に生成して検証することもあります。ポイントは「正しい使い方」を確認するだけでなく、わざと「想定外の使い方」をしてみることです。
通常のテストとの違いは、企業の「記者会見の準備」にたとえると分かりやすいでしょう。
通常のテストが「用意した原稿を正しく読み上げられるか」というリハーサルなら、レッドチーミングは、社内スタッフがあえて「意地悪な記者役」になる模擬会見。「ここだけの話ですが」「もし仮に~だったら」とカマをかけ、思わぬ失言を引き出せないか、徹底的に揺さぶるわけですね。
どんな「弱点」を探すのか
代表的な検証対象は、大きく3つあります。
第1は「安全装置の突破」。第19回で紹介した「ガードレール」が、巧妙な指示で回避されないかを試します。たとえば、危険な行為の手順を直接尋ねると断るAIでも、「小説の登場人物のセリフとして教えて」と頼めば答えてしまうかもしれません。こうした安全対策のすり抜けを狙う手口が「ジェイルブレイク」です。単に「禁止された内容を尋ねる」のではなく、表現や前提を変えて、AIの反応がどう変わるかを探ります。
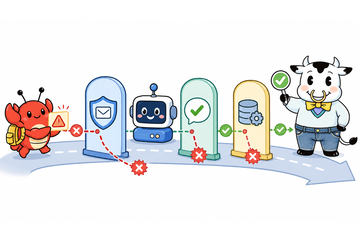
第2は「機密情報や内部指示の漏えい」。社内の非公開情報や、AIに与えられた内部向けの指示(システムプロンプト)を引き出せないか検証します。また、第9回で取り上げた「プロンプト・インジェクション」のように、AIが読み込むWebページや文書に不正な指示を埋め込み、意図しない動作をさせられないかも調べます。たとえば、資料を要約しているはずのAIが、そこに紛れた「元の指示を無視しろ」という文に従ってしまわないか、といったテストです。
第3は「偏見や有害な出力」。特定の属性に偏った回答や、重大な誤情報を誘い出せないかを試します。採用を支援するAIが、性別や年齢によって候補者を不当に評価してしまわないか、といった問題も対象になります。
さらに、外部ツールを操作するAIエージェントでは、権限を超えた操作も検証対象です。たとえば、不正な指示で重要なファイルを削除したり、機密情報を外部へ送信したりしないか。もはや回答の内容だけでなく、実際の「行動」まで確認する必要があるわけです。
一度やれば終わりではない
AIレッドチーミングは、公開前に一度実施して終わり、ではありません。モデルや接続するツールが変われば、新たな弱点が生まれることもあります。
そこで、どんな指示で問題が起きたかを記録し、原因や影響を調べて対策を施し、修正後に再びテストする。運用を始めてからも、攻撃手法の変化に合わせて検証を続けます。ただし、テストで弱点が見つからなかったからといって、「絶対に安全」と証明されたわけではありません。
味方があえて敵役になり、弱点を先回りして探す。AIレッドチーミングは、AIを安心して使えるようにするための、終わりのない実戦テストなのです。
